
RAG и търсене в документи
Какво е RAG и как AI отговаря от вашите документи
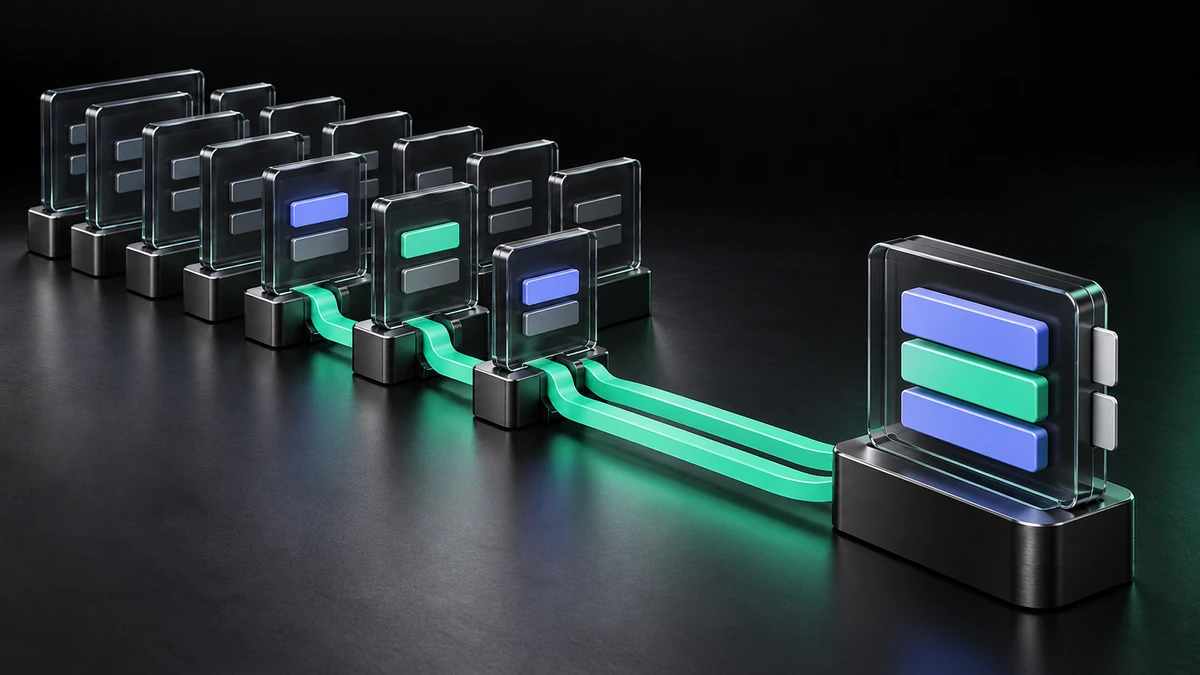
RAG (Retrieval-Augmented Generation) е подход, при който AI първо намира подходящи откъси от външни източници и след това ги използва, за да отговори. При фирмени документи това означава търсене в одобрени инструкции, условия или каталози и отговор с посочен източник. Документите се подават като контекст за конкретния въпрос; моделът не се обучава наново при всяка промяна.
 Александър Чакмаков
Какво означава RAG за фирмените ви документи
Клиент пита дали гаранцията покрива повреда при транспорт. Отговорът е в условията ви, но служителят трябва да намери правилната версия, да прочете раздела и да върне точен отговор. RAG свързва това търсене с езиков модел - софтуера, който разбира въпроса и формулира текста.
Името Retrieval-Augmented Generation описва последователността: намиране на информация, добавянето ѝ към заявката и генериране на отговор. Научната публикация за RAG разглежда комбинирането на езиков модел с външна памет, от която се извличат пасажи. В бизнес приложение източникът може да е вашият архив.
За собственика на фирма полезният резултат е конкретен: отговорът сочи откъде идва и служителят може да го провери. Това изисква разработена връзка с документите, правила за търсене и проверка на качеството. Добавянето на чат поле към сайта не осигурява тези части само по себе си.
Как работи RAG: подготовка на архива и търсене при въпрос
Има два отделни процеса. Първо документите се подготвят за търсене. От PDF файл се извлича текстът, запазват се заглавията и източникът, а съдържанието се разделя на откъси. Тази стъпка се нарича chunking. Всеки откъс трябва да съдържа достатъчно контекст, за да се разбере.
След това, при всеки въпрос, системата намира подходящите откъси и ги подава на модела. File search на OpenAI е пример за готов инструмент, който търси по смисъл и ключови думи в качени файлове. Конкретната реализация се избира според достъпа, източниците и нужните проверки.
01 / Два процеса с различен момент на изпълнение
- ПРИ ДОБАВЯНЕДокументИзвличане на текст, версия и права за достъп.
- ПОДГОТОВКАОткъсиСмислени части с връзка към оригинала.
- СЪХРАНЕНИЕИндексДанни, подготвени за последващо търсене.
- ПРИ ВСЕКИ ВЪПРОСТърсенеСамо сред документите, разрешени за човека.
- КОНТЕКСТПодбрани откъсиНай-подходящите източници за конкретния въпрос.
- ОТГОВОРТекст и източникПроверимо обяснение или отказ при липса на данни.
Сканираният PDF изисква OCR - разпознаване на текст от изображение. Ако таблица се прочете в грешен ред или бележка под линия се отдели от условието, следващите стъпки могат да дадат убедителен, но грешен отговор. Затова проверката започва от извлечения текст.
Пример: от въпрос за гаранция до конкретен източник
Търговец на осветление има условия за гаранция и доставка в отделни документи. Потребителят пита: „Какво да изпратя при заявка за гаранционен ремонт?“.
02 / Условия за гаранция и доставка
Какво да изпратя при гаранционна заявка?
Към заявката се прилагат номерът на поръчката, описание на проблема и снимка на продукта.
Адресът за доставка може да се промени преди предаване на куриер.
Изпратете номера на поръчката, описание на проблема и снимка на продукта. Източник: „Гаранционна процедура v3“, §2.
В работещото приложение заглавието на източника води към разрешения документ и точния раздел или страница. Версията помага да се установи дали отговорът използва текущите условия. Ако клиентът пита дали ремонтът вече е одобрен, общата процедура не е достатъчна: нужна е справка по неговата конкретна заявка.
При въпрос извън наличните документи очакваният резултат е ясно съобщение, че информацията липсва, и начин за контакт с човек. „Не намирам условие за този случай“ е полезен отговор, когато алтернативата е измислено обещание.
Търсене по смисъл, ключови думи и точни кодове
Семантично търсене означава търсене по смисъл. „Лампата спря да свети“ може да намери откъс за „дефект на осветителното тяло“, въпреки че думите са различни. Често това използва embeddings - числово представяне на съдържанието, чрез което се сравнява близостта по смисъл.
Ръководството за retrieval на OpenAI обяснява този механизъм и индексирането във vector stores. За каталожен код, номер на договор или съкращение точното съвпадение остава важно. Комбинацията се избира с реални въпроси, включително изписани с грешки.
Разработили сме търсене по смисъл в архив от 1,7 млн. изображения за платформа с 2,3 млн.+ търсения. При такъв архив намирането на подходящ резултат е самостоятелна задача. При RAG към нея се добавя формулирането на отговор от намереното съдържание и проверката дали той се подкрепя от него.
Защо RAG може да сгреши и как го проверяваме
RAG дава на модела по-подходящ контекст, но не гарантира истинност. Системата може да намери стара инструкция, да пропусне изключение или да смеси условия за различни продукти. Правилният откъс също може да бъде изтълкуван погрешно.
Преди пускане подготвяме проверими въпроси с очакван източник. Проверяваме отделно дали търсенето намира нужния пасаж и дали крайният отговор следва от него. Ако правилният документ не е намерен, смяната на формулировката на отговора не поправя търсенето.
- Въпрос с ясен отговор: намира ли се правилният раздел?
- Въпрос с изключение: запазва ли се условието към правилото?
- Липсваща информация: отказва ли системата да предполага?
- Стара версия или чужд документ: изключени ли са от текущия отговор?
Измерваме и времето за отговор и разхода при тези въпроси. Няма полезен общ процент за „точност“, ако не е ясно кои случаи са проверени. Същите въпроси се изпълняват отново при промяна на източниците или начина на търсене.
Публични документи и лични клиентски данни
Публичният чатбот може да чете общите условия. Личният договор и отстъпката на конкретен клиент имат различни права. Ограничението се прилага преди откъсът да бъде изпратен на модела; инструкция „не показвай чужди данни“ не е проверка на достъпа.
03 / Достъпът определя къде се търси
Общи инструкции и публичен каталог. Личните документи са изключени.
Филтриране на разрешените източници преди подаване на контекст.
Общите документи и неговите собствени записи. Чуждите договори са изключени.
Преди реална употреба се уточнява кои данни достигат до доставчика на модела и какви записи пази приложението. При отнет достъп индексът и запазените резултати трябва да следват новите права. Това е част от разработката на системата.
Разликата между RAG, обучение на модел и MCP
Fine-tuning е допълнително обучение с примери, което променя поведението на модела. RAG подава намерена информация по време на заявката. Двата подхода могат да се комбинират. Документацията за оптимизация на OpenAI разглежда подаването на контекст и обучението като различни средства за подобряване на резултата.
За инструкции, които се променят, RAG позволява да обновите източника и индекса, без да обучавате модела за всяка редакция. Нужни са правила за активната версия, изтриването и проследяването на източника.
MCP server предоставя функция на AI приложение. Тази функция може да е RAG търсене. Ако задачата е справка за текуща наличност, директното запитване към складовата система често е по-подходящо от отговор по стар PDF каталог.
Как да започнете с RAG чатбот за вашата фирма
Изберете повтарящ се въпрос и ограничен набор актуални документи. Дайте примери за правилен отговор, за непокрит случай и за документ, до който потребителят няма достъп. Така първата версия може да се оцени с вашите данни.
За клиентски разговори вижте разработката на AI чатбот. Ако търсенето влиза във вътрешен процес или приложение, разработката на AI приложение с RAG включва и тази връзка. Цената зависи от качеството на документите, обновяването, правата и интеграциите; обхватът се уточнява след преглед на източниците.
Техническите източници и връзки към инструментите са проверени на 28 октомври 2026.
Често задавани въпроси
Какво означава RAG на разбираем език?
RAG е търсене на подходяща информация преди генерирането на отговор. Асистентът получава намерените откъси като контекст и използва тях, за да отговори на конкретния въпрос.
RAG гарантира ли верен отговор?
Не. Търсенето може да намери грешен или стар откъс, а моделът може да го изтълкува неправилно. Нужни са проверени източници, тестови въпроси и ясен отказ, когато липсва достатъчно информация.
Може ли RAG чатбот да работи с PDF файлове?
Да, ако съдържанието може да бъде извлечено правилно. Сканираните страници изискват разпознаване на текст, а таблиците и сложните оформления се проверяват отделно. Запазва се връзката към документа и страницата.
Нужна ли е векторна база данни за RAG?
Не във всеки проект. RAG изисква намиране на полезен контекст. То може да използва търсене по ключови думи, векторно търсене по смисъл или комбинация според данните и въпросите.
Как се обновява RAG при промяна на документ?
Промененият документ се обработва и съответните откъси се обновяват в индекса. Старите версии се изключват от текущите отговори, а изтритите или вече недостъпни документи се премахват според правилата за достъп.


